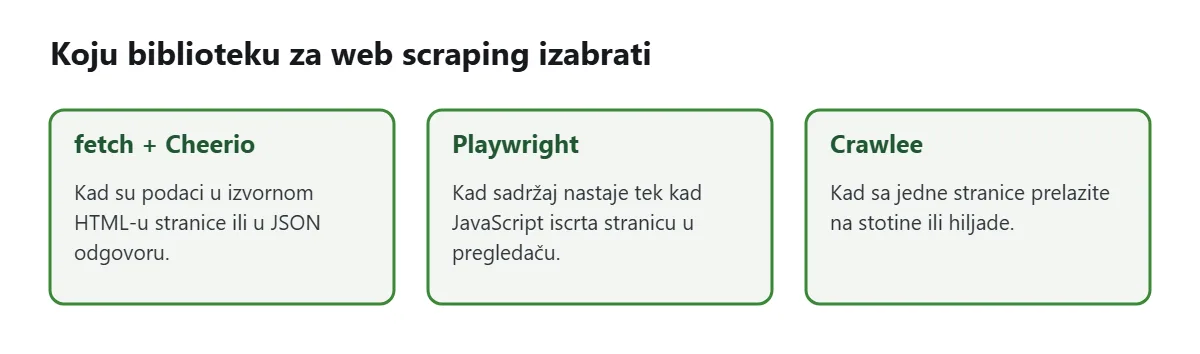
Najbolje Node.js biblioteke za web scraping u 2026. su tri, i svaka rešava drugi problem. Ako je podatak već u HTML-u koji server vraća, uzmite Cheerio uz fetch koji je ugrađen u Node.js: nema browsera koji treba preuzeti i pokretati, a ceo primer niže ima tridesetak linija. Ako sadržaj iscrtava JavaScript tek u browseru, treba vam Playwright. Kada od jedne stranice nastane hiljadu, pa vam zatrebaju red adresa, ponovni pokušaji i ograničenje brzine, uzmite Crawlee.
Kako smo birali
Biblioteke smo poredili po vrsti posla: čitanje statičkog HTML-a, upravljanje pravim browserom i crawling većeg broja stranica. Verzije, datume izdanja i zahteve za Node.js proverili smo na npm registru i u zvaničnoj dokumentaciji 12. novembra 2026. Primere iz teksta pokrenuli smo na Windowsu 11 sa Node.js 24.20.0, nad sajtovima books.toscrape.com i quotes.toscrape.com, koji postoje upravo da bi se na njima vežbao scraping. Biblioteke nismo poredili po brzini niti po tome koliko ih često sajtovi blokiraju. Sve su besplatne i otvorenog koda, pod licencom MIT ili Apache 2.0.
Koji alat za koji posao
| Biblioteka | Verzija (novembar 2026) | Izvršava JavaScript | Uzmite je za | Preskočite je ako |
|---|---|---|---|---|
| Cheerio | 1.2.0 | ne | statičan HTML: kataloge, cenovnike, oglase, vesti | se sadržaj pojavljuje tek u browseru |
| Playwright | 1.65.0 | da (Chromium, Firefox, WebKit) | stranice koje crta JavaScript, klikove, prijavu, skrolovanje | je podatak već u HTML-u ili u JSON odgovoru |
| Puppeteer | 25.17.0 | da (Chrome, Firefox) | projekte koji ga već koriste | počinjete od nule |
| Crawlee | 3.18.2 | zavisi od izabranog crawlera | stotine i hiljade stranica, red, ponovne pokušaje, proxy | vam treba jedna stranica |
| jsdom | 31.0.0 | samo uz runScripts: "dangerously" | kod koji očekuje window i document | treba da izvršite skripte sa tuđe stranice |
| node-html-parser | 9.0.7 | ne | parsiranje ogromne količine HTML-a sa diska | je HTML loše formiran |
Prvo proverite da li vam uopšte treba browser
Browser je najteži alat na ovoj listi. Cheerio je brz baš zato što ne radi ono što browser radi: njegova dokumentacija navodi da nema vizuelnog renderovanja, CSS-a, učitavanja spoljnih resursa ni izvršavanja JavaScripta. Pre izbora alata zato otvorite izvorni kod stranice (u Chrome-u Ctrl+U, na Macu Option+Command+U) i potražite podatak koji vam treba.
Sajt quotes.toscrape.com ima istu listu citata u tri verzije, pa se razlika lepo vidi. Na naslovnoj strani Cheerio nalazi 10 elemenata .quote. Na adresi /js/ isti kod nalazi nula: citati su u HTML-u samo kao JavaScript niz unutar <script> taga, a elemente pravi skripta tek u browseru. Treća verzija, /scroll, učitava citate sa adrese /api/quotes?page=1, koja vraća čist JSON. Za nju ne treba ni parser:
const res = await fetch('https://quotes.toscrape.com/api/quotes?page=1');
const data = await res.json();
console.log(data.quotes.length, data.has_next);
Sačuvajte kod kao api.mjs i pokrenite ga:
node api.mjsIspis je 10 true: deset citata i podatak da postoji sledeća strana. Na pravom sajtu takav JSON tražite u DevTools-u. Otvorite karticu Network, uključite filter Fetch/XHR i osvežite stranicu. Ako se podatak pojavi u nekom od odgovora, preskočite i parser i browser. Ako ga nema ni tu ni u izvornom kodu, tek tada vam treba Playwright.
Cheerio: najbolji izbor za većinu poslova
Cheerio parsira HTML i daje API sličan jQuery-ju, pa $('h3 a').attr('title') radi ono što očekujete. Aktuelna verzija je 1.2.0, iz januara 2026. Verzija 1.0 stigla je u avgustu 2024, posle sedam godina u fazi release candidate, i donela metod $.extract(): opišete koje polje dolazi iz kog selektora i dobijete običan JavaScript objekat, bez ručnih petlji kroz elemente.
Uzmite ga za kataloge, cenovnike, oglase, rezultate pretrage i sve ostalo što vidite u izvornom kodu stranice. Preskočite ga kada je stranica prazna dok je JavaScript ne popuni. Cheerio tada vidi isto što i curl, odnosno ništa korisno.
Naslovi, cene i linkovi sa jedne stranice
1. Proverite verziju Node.js-a. Biblioteke iz ovog teksta podržavaju aktuelna izdanja LTS linija 22, 24 i 26.
node -vKomanda vraća broj verzije, na primerv24.20.0
. Ako komanda ne radi, pogledajtekako da proverite da li je Node.js instaliran
. Ako dobijete verziju 20 ili stariju, prvoažurirajte Node.js
, jer je linija 20 bez podrške od 30. aprila 2026.
2. Napravite projekat i instalirajte Cheerio. Komande su iste u PowerShellu na Windowsu, na macOS-u i na Linuxu.
mkdir scraper
cd scraper
npm init -y
npm pkg set type=module
npm install cheerio
3. Sačuvajte sledeći kod kaoscrape.js
.
import * as cheerio from 'cheerio';

const url = 'https://books.toscrape.com/';

const res = await fetch(url, {
  headers: { 'User-Agent': 'moj-scraper/1.0 (kontakt@example.com)' },
});
if (!res.ok) {
  throw new Error(`HTTP ${res.status} za ${url}`);
}

const $ = cheerio.load(await res.text(), { baseURI: url });

const { books } = $.extract({
  books: [
    {
      selector: 'article.product_pod',
      value: {
        title: { selector: 'h3 a', value: 'title' },
        price: '.price_color',
        url: { selector: 'h3 a', value: 'href' },
      },
    },
  ],
});

console.log(`Pronađeno knjiga: ${books.length}`);
console.log(books.slice(0, 2));
4. Pokrenite ga.
node scrape.jsOčekivani ispis:
Pronađeno knjiga: 20
[
  {
    title: 'A Light in the Attic',
    price: '£51.77',
    url: 'https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html'
  },
  {
    title: 'Tipping the Velvet',
    price: '£53.74',
    url: 'https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html'
  }
]
Opcija baseURI pretvara relativne linkove kao catalogue/a-light-in-the-attic_1000/index.html u pune adrese, pa ih ne sastavljate ručno. Provera res.ok je tu zato što fetch ne baca grešku kada server vrati 404 ili 503, nego uredno vrati stranicu sa greškom. Bez provere biste parsirali nju i dobili prazan niz bez ikakvog upozorenja. Zaglavlje User-Agent sa nazivom i kontaktom govori vlasniku sajta ko mu šalje zahteve i kome da se javi ako mu ti zahtevi smetaju.
Playwright: kada stranicu crta JavaScript
Playwright pokreće pravi browser bez prozora. Stranicu dobijate onakvu kakvu vidi posetilac, posle izvršenih skripti, i možete da kliknete, popunite formu, prijavite se ili skrolujete do kraja liste. Radi sa Chromiumom, Firefoxom i WebKitom. Aktuelna verzija je 1.65.0 od 5. novembra 2026. Zvanično podržava Node.js 22, 24 i 26, a na serveru Debian 12 i 13 i Ubuntu 22.04, 24.04 i 26.04.
Za scraping vam treba paket playwright. Paket @playwright/test je test runner i ovde vam ne treba. U istom folderu kao prethodni primer instalirajte biblioteku i Chromium koji ona koristi:
npm install playwright
npx playwright install chromium
Na Ubuntu serveru browseru trebaju i sistemske biblioteke. Jedna komanda instalira i njih i browser:
npx playwright install --with-deps chromiumAko Node.js na serveru tek postavljate, postupak je opisan u tekstu kako instalirati Node.js na Ubuntu. Zatim sačuvajte kod kao quotes.js:
import { chromium } from 'playwright';

const browser = await chromium.launch();
const page = await browser.newPage();
await page.goto('https://quotes.toscrape.com/js/');
await page.locator('.quote').first().waitFor();

const quotes = await page.locator('.quote .text').allTextContents();
console.log(`Pronađeno citata: ${quotes.length}`);

await browser.close();
node quotes.jsIspis je Pronađeno citata: 10, sa iste stranice na kojoj je Cheerio našao nulu. Red sa waitFor() nije ukras. Metod allTextContents() vraća ono što je na stranici u tom trenutku i ne čeka da se lista pojavi. Na adresi /js-delayed/ sajt dodaje citate sa zakašnjenjem, pa naš kod bez tog reda tamo vraća 0 citata, a sa njim 10. Dokumentacija za Locator isto upozorenje daje za srodni metod all(): listu koja se učitava dinamički treba sačekati pre čitanja.
Playwright je pravi izbor čim podatak nije ni u izvornom kodu ni u nekom JSON odgovoru. Za sve ostalo je preskup: preuzimate ceo browser, svaka stranica se učitava sa skriptama, slikama i fontovima, a na kraju dobijate isti HTML koji vraća i običan fetch.
Puppeteer: ako već imate kod za njega
Puppeteer radi isti posao kao Playwright, ali na užem polju: upravlja Chrome-om, a preko protokola WebDriver BiDi i Firefoxom. Verzija 25.17.0 izašla je 10. novembra 2026. i traži Node.js 22.12.0 ili noviji. Razlika se oseti već pri instalaciji. npm install puppeteer sam preuzima Chrome for Testing, prema zvaničnom uputstvu oko 280 MB na Windowsu, 282 MB na Linuxu i 170 MB na macOS-u. Ako menadžer paketa blokira install skripte, preuzimanje se preskoči i pri pokretanju dobijate grešku „Could not find Chrome”. Browser tada instalirate ručno:
npx puppeteer browsers installZa nov projekat bolji je Playwright, jer istim API-jem pokriva Chromium, Firefox i WebKit. I dokumentacija Crawleeja preporučuje Playwright svima koji Puppeteer već ne poznaju. Ako nasleđujete projekat pisan za Puppeteer i on radi, nema razloga da ga prepisujete.
Crawlee: kada jedna stranica postane hiljadu
Primer sa Cheeriom obrađuje jednu stranu kataloga, a books.toscrape.com ih ima 50. Petlja kroz 50 adresa je lak deo posla. Teži deo počinje kada jedna adresa vrati grešku, kada skripta pukne na 37. strani pa sve kreće ispočetka ili kada sajt počne da odbija prebrze zahteve. Crawlee, projekat kompanije Apify, rešava baš to. Ima trajni red adresa, ponovne pokušaje posle greške, automatsko skaliranje prema resursima računara, rotaciju proxy servera i zaglavlja koja liče na ona iz browsera. Za jednu stranicu, ili za skriptu koju pokrećete jednom, to je višak: tu su dovoljni fetch i Cheerio.
Cheerio i Playwright ne zamenjuje, nego ih koristi. CheerioCrawler preuzima stranice HTTP zahtevima i parsira ih Cheeriom, a PlaywrightCrawler i PuppeteerCrawler pokreću browser. Sva tri imaju isti interfejs, pa je prelazak sa jednog na drugi jednostavan. Stabilna verzija je 3.18.2 iz septembra 2026. Ona nosi sopstvenu, stariju verziju Cheerija (1.0.0-rc.12), u kojoj metod $.extract() iz prvog primera ne postoji, pa primer niže čita elemente metodama map() i get(). Verzija 4 je u novembru 2026. u fazi release candidate i traži Node.js 22.13 ili noviji.
Pre nego što crawler pustite na tuđ sajt, otvorite njegov /robots.txt. Taj fajl, standardizovan kao RFC 9309, kaže koje delove sajta vlasnik ne želi da roboti obilaze, a opcija respectRobotsTxtFile: true u primeru niže te adrese preskače. RFC pritom naglašava da ta pravila nisu oblik autorizacije pristupa, pa poštovanje robots.txt nije isto što i dozvola. Uslovi korišćenja sajta mogu da zabrane scraping. Čim prikupljate imena, mejl adrese ili druge podatke o ljudima, u Srbiji se primenjuje Zakon o zaštiti podataka o ličnosti, a na podatke ljudi iz Evropske unije može da se primeni i GDPR. Brzinu ograničite opcijom maxRequestsPerMinute, kao u primeru niže, i preuzimajte samo ono što vam zaista treba.
U istom folderu instalirajte Crawlee:
npm install crawleePosle instalacije npm prijavljuje 12 ranjivosti srednje ozbiljnosti (stanje 12. novembra 2026). Sve potiču od jednog bezbednosnog upozorenja za paket minimatch, GHSA-g3hv-75wg-m249: da bi ga iskoristio, napadač mora sam da zada glob šablon, a u scraperu šablone pišete vi. npm audit kao rešenje predlaže npm audit fix --force. Ne pokrećite tu komandu, jer bi vratila Crawlee na verziju 3.2.2 iz februara 2023. Ispravka stiže sa Crawleejem 4: verzija 4.0.0-rc.2 više ne prijavljuje nijednu ranjivost.
Zatim sačuvajte kod kao crawl.js:
import { CheerioCrawler, Dataset } from 'crawlee';

const crawler = new CheerioCrawler({
  maxRequestsPerCrawl: 10,
  maxRequestsPerMinute: 60,
  respectRobotsTxtFile: true,
  async requestHandler({ $, request, enqueueLinks }) {
    const books = $('article.product_pod h3 a')
      .map((_, a) => ({ title: $(a).attr('title'), page: request.loadedUrl }))
      .get();
    await Dataset.pushData(books);
    await enqueueLinks({ selector: 'li.next a' });
  },
});

await crawler.run(['https://books.toscrape.com/']);
node crawl.jsCrawlee ispisuje tok rada, a poslednji red izgleda ovako:
INFO CheerioCrawler: Finished! Total 10 requests: 10 succeeded, 0 failed. {"terminal":true}Crawler prati link „next” kroz deset strana kataloga, koliko dozvoljava maxRequestsPerCrawl: 10, i u folder storage/datasets/default upisuje po jedan JSON fajl za svaku od 200 knjiga. Za novi projekat od nule postoji i npx crawlee create my-crawler, koji postavlja zavisnosti i osnovni kod, kako je opisano u Crawlee uputstvu za početak.
Crawler koji treba da radi svakog dana obično završi na serveru, a ne na laptopu. Kakav vam je hosting za to potreban, opisali smo u tekstu o najboljem Node.js hostingu.
Kada su bolji jsdom ili node-html-parser
jsdom (verzija 31.0.0 od 5. novembra 2026) je implementacija web standarda u čistom JavaScriptu. Dobijate window, document i querySelector kao u browseru, pa je zgodan kada već imate kod koji radi sa DOM API-jem i ne želite da ga prepisujete za Cheerio. Layout i renderovanje ne radi. Skripte sa stranice izvršava samo uz opciju runScripts: "dangerously", a njegov README upozorava da sandbox nije neprobojan i da nepoznat kod može da ugrozi računar. Za stranice koje crta JavaScript zato birajte Playwright, ne jsdom.
node-html-parser (9.0.7) pravi pojednostavljeno DOM stablo i brzinu stavlja ispred svega. U benchmarku koji projekat objavljuje na GitHubu (jun 2026) prosečan fajl parsira za oko 1 ms, a Cheerio za oko 3,3 ms. README priznaje i cenu: deo loše formiranog HTML-a možda neće biti ispravno parsiran. U našem Crawlee pokretanju prosečan zahtev trajao je 413 ms, pa razlika od dve milisekunde u parsiranju na takvom poslu gotovo ništa ne menja. node-html-parser se isplati kada obrađujete HTML koji je već na disku, u milionima fajlova.
Šta više ne treba instalirati
Stari tutorijali i dalje preporučuju pakete koje danas treba zaobići. request je na npm-u označen kao zastareo, a poslednja verzija izašla je u februaru 2020. x-ray (jul 2019) i nightmare (april 2019) nisu dobili novo izdanje više od sedam godina. Ni node-fetch vam ne treba, jer je fetch ugrađen u Node.js i stabilan od verzije 21. Iz istog razloga za običan GET zahtev nije potreban ni axios. Ako tutorijal počinje sa require('request'), zatvorite ga: za prvi scraper dovoljni su fetch i Cheerio.